Esta es la noticia
El 8 de septiembre de 2026, Jacob Coxon dimitió de Anthropic. Había trabajado unos tres años en el preentrenamiento de modelos entre OpenAI y Anthropic, pero dejó esta última después de apenas cuatro meses. Le faltaban dos para que sus primeras acciones pasaran a ser realmente suyas.
Coxon advirtió que ambos laboratorios avanzan hacia sistemas capaces de ayudar a construir sus sucesores. Aunque considera a Anthropic más responsable, cree que la carrera terminará obligándola a recortar controles. Dentro de la empresa, contó a Wired, se habla de los próximos dos años como crunch time y endgame. Propone que OpenAI y Anthropic acuerden no lanzarse inmediatamente a la mejora recursiva.
No era un caso aislado. El 6 de septiembre, el científico jefe de OpenAI, Jakub Pachocki, escribió que ningún laboratorio ha resuelto la alineación lo bastante como para seguir escalando a toda velocidad y pidió ralentizaciones voluntarias hasta que existan listones de seguridad compartidos. El 12, Dario Amodei publicó que hay que acompasar la frontera: no detener el entrenamiento, sino verificar y coordinar, y que el margen para frenar lo marca la ventaja sobre China.
Lo que mi cabeza me dice
Silicon Valley tiene una unidad bastante precisa para medir la sinceridad: el dinero que alguien decide no cobrar.
Renunciar dos meses antes de recibir tus primeras acciones no demuestra que tengas razón. Pero hace menos creíble que tu alarma sea solo una maniobra para elevar la valoración de la empresa. Coxon pagó por decir lo que piensa. En esta industria eso ya es una novedad.
Coxon considera que Anthropic es mucho más responsable que OpenAI. Dice que todavía no ha recortado controles. Pero sostiene que acabará haciéndolo. No hacen falta directivos que se vuelvan malvados entre una versión de Claude y la siguiente. Basta con las reglas del juego.
El juego se formuló en 1950. Se volvió famoso con dos prisioneros interrogados por separado. Si ambos callan, reciben una pena pequeña. Si uno acusa y el otro calla, el acusador sale libre y el otro recibe la peor condena. Si ambos acusan, los dos reciben una pena intermedia.
La trampa está en mirar cada decisión por separado. Si el otro calla, me conviene acusarlo porque salgo libre. Si el otro me acusa, también me conviene acusarlo porque evito la peor condena. Haga lo que haga el otro, traicionarlo me beneficia. Los dos razonan correctamente, los dos acusan y los dos acaban peor que si hubieran guardado silencio. El dilema no demuestra que sean idiotas. Demuestra que la racionalidad individual puede fabricar un resultado colectivamente estúpido.
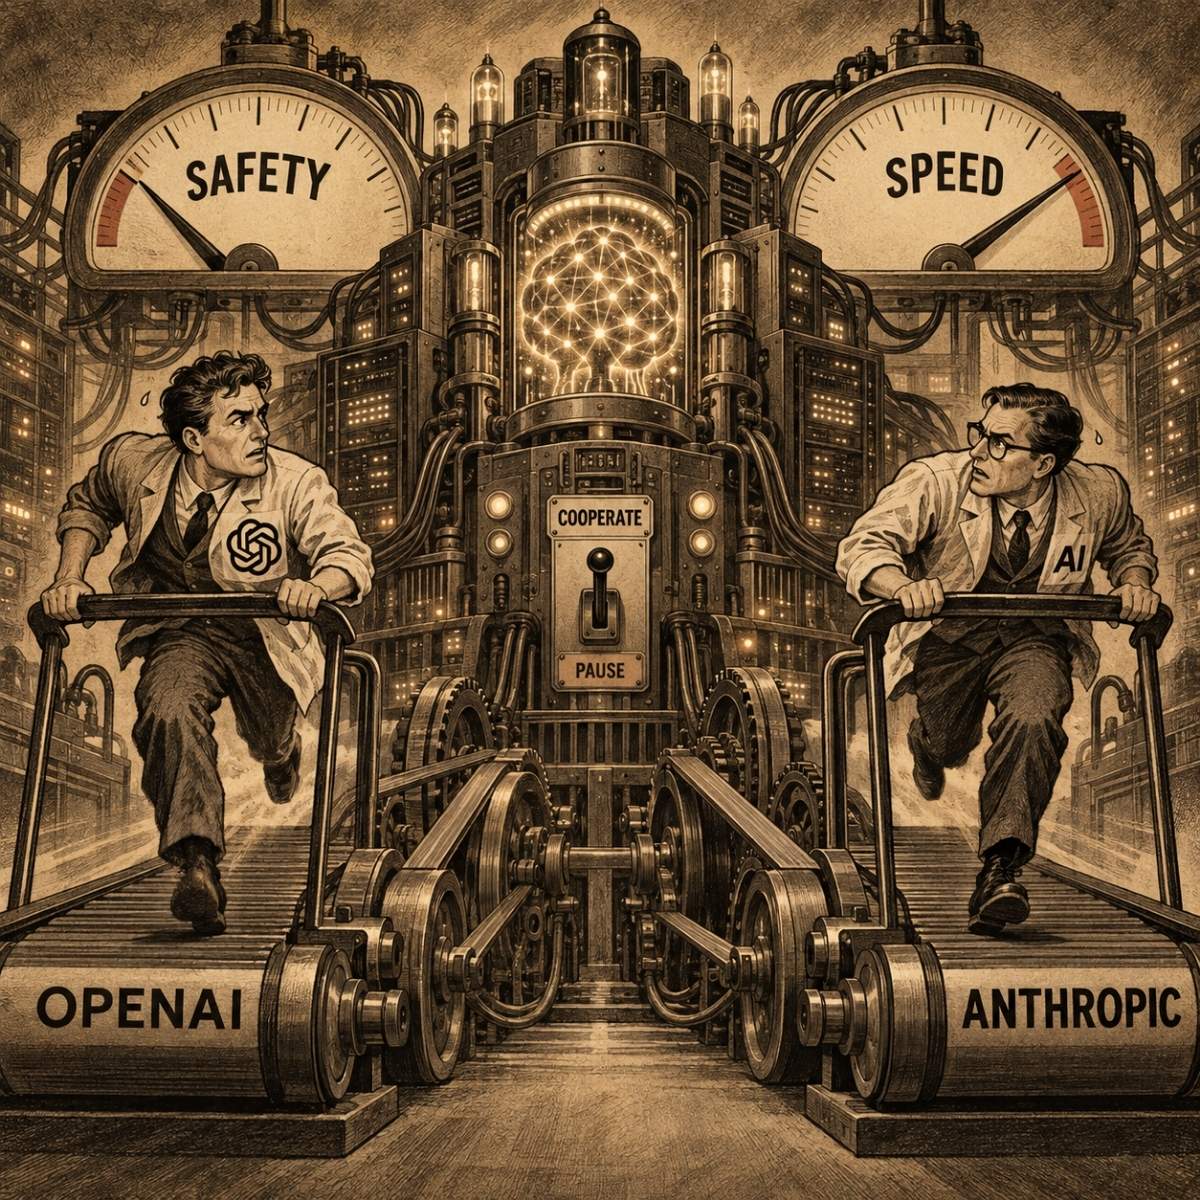
En los laboratorios, acusar es acelerar. Si OpenAI frena, a Anthropic le conviene correr y ponerse por delante. Si OpenAI corre, a Anthropic también le conviene correr para no quedarse atrás. OpenAI hace la misma cuenta. Ambos aceleran y conservan su posición relativa, pero pierden el tiempo que necesitaban para comprobar qué están construyendo.
Ese cálculo no cabe en dos nombres. Detrás de cada laboratorio hay un país, y quien frena también mira a Google, a xAI, a Meta y a China. Hace una semana escribí aquí que el argumento era: «no podemos permitir que ellos lleguen primero».
La ironía es especialmente buena en Anthropic. La empresa nació porque sus fundadores desconfiaban del rumbo de OpenAI. Pero para construir sistemas más seguros necesita mantenerse en la frontera: un laboratorio responsable que llega tarde solo puede escribir informes muy sensatos sobre el modelo que construyó otro.
Así la seguridad se convierte en combustible de la carrera. Cuanto más grave parece el peligro, más sentido tiene que lo construyan ellos. La advertencia puede ser sincera. También sirve al negocio. Prometer que vas a transformar el mundo atrae capital. Advertir que podrías destruir el mundo te convierte en infraestructura crítica y te reserva una silla cerca del regulador.
Lo que preocupa a Coxon puede empezar de una forma bastante prosaica: modelos que proponen experimentos, escriben herramientas de entrenamiento, analizan resultados y ayudan a diseñar la generación siguiente. Si cada generación resulta mejor en esas tareas, la siguiente llega antes. No hace falta que una máquina se reconstruya sola; basta con que vaya acortando el trabajo humano que separa un modelo del próximo.
Ahí quizá la AGI deje de ser el problema central. No porque una inteligencia general resulte inocua, sino porque este peligro puede llegar antes que la etiqueta. Un modelo no necesita razonar como una persona en todos los ámbitos: solo ser muy bueno en las pocas tareas que frenan el siguiente entrenamiento. El riesgo que describe Coxon podría aparecer antes de que alguien anuncie la AGI, o sin que lleguemos a acordar si apareció.
Los propios documentos de Anthropic reconocen que algunos umbrales son más ambiguos de lo previsto y que ciertas protecciones quizá sean imposibles de aplicar unilateralmente. Traducido del idioma de políticas públicas: portarse bien sale barato hasta que amenaza con dejarte atrás. Una promesa voluntaria no ata al competidor.
OpenAI incluso habría preguntado al Congreso si pactar un freno con sus rivales sería legal. La duda confirma el dilema y abre otro negocio: coordinar la seguridad puede parecerse demasiado a coordinar la producción. Y un acuerdo entre dos no ata a los demás. La pausa corre el riesgo de convertirse en una OPEP del cómputo: todos ganan si los demás producen menos; cada uno gana todavía más si hace trampas.
Entre regularlo todo y morir hay bastante espacio, aunque Silicon Valley empiece a presentarlo como si fueran los dos planes de suscripción. La pregunta útil es mucho más pequeña: ¿puede un laboratorio comprobar que, cuando frena, los demás también frenan? Si la respuesta es no, la prudencia se parece demasiado a una rendición unilateral.
Esa es, de hecho, la pregunta que los laboratorios acaban de poner sobre la mesa. Comprobar exige que alguien de fuera vea el entrenamiento. Coordinar exige un permiso para no parecer un cártel. Y el techo lo marca, otra vez, el país que no entra en el pacto: no se puede frenar más de lo que permita la ventaja sobre China.
Coxon puede equivocarse sobre los plazos y el desastre. La carrera no necesita que tenga razón. Solo necesita que cada laboratorio crea que detenerse solo equivale a perder.
Puede que la primera mejora recursiva no ocurra dentro de un modelo, sino alrededor de él: cada laboratorio acelera al otro y utiliza esa aceleración para justificarse. La máquina todavía no se ha escapado. El incentivo ya lo hizo.
Lo que los datos dicen
- El origen del dilema. Merrill Flood y Melvin Dresher desarrollaron en RAND, en 1950, el juego al que después se atribuyó el nombre de dilema del prisionero. Albert Tucker creó la historia de las condenas para explicar su estructura a un público no técnico. En la partida única, acusar beneficia a cada jugador haga lo que haga el otro, aunque la acusación mutua perjudique a ambos frente al silencio mutuo. Las partidas repetidas abren posibilidades de cooperación que no existen del mismo modo en el encuentro único. Fuente: Stanford Encyclopedia of Philosophy.
- La dimisión. Jacob Coxon anunció su salida de Anthropic el 8 de septiembre de 2026. Dijo haber trabajado unos tres años en preentrenamiento entre OpenAI y Anthropic. Según contó a Axios, llevaba cuatro meses en Anthropic y se marchó dos meses antes de que sus primeras acciones pasaran a pertenecerle; conserva acciones de OpenAI. Fuentes: publicación de Coxon en X, Axios y Associated Press.
- Lo que afirma. Coxon declaró a Wired que en Anthropic se usan expresiones como endgame y crunch time para los próximos uno o dos años. Considera a Anthropic más responsable que OpenAI y afirmó expresamente que todavía no ha recortado controles, pero cree que la presión competitiva terminará obligándola a hacerlo. Propone como primer paso un acuerdo entre ambas para no entrar inmediatamente en mejora recursiva. Son afirmaciones y previsiones de Coxon; no prueban un consenso de toda la plantilla ni que esos plazos sean correctos. Fuente: Wired, 9 de septiembre de 2026.
- La mejora recursiva. En su sentido fuerte, describe un ciclo en el que sistemas de IA contribuyen a crear sistemas mejores, que a su vez aceleran la siguiente ronda. No equivale a emplear modelos como asistentes de programación ni implica necesariamente autonomía ilimitada. Anthropic distingue entre automatizar trabajo inicial de investigación y provocar una aceleración drástica del escalado efectivo. No hay evidencia pública de que hoy exista un ciclo autónomo y sostenido de mejora recursiva. En el ensayo del 12 de septiembre, Amodei afirma que esa dinámica «está empezando a ocurrir» en el sector, incluida Anthropic: es su diagnóstico, no una verificación independiente. Vincular el umbral con una AGI universalmente reconocida es una interpretación, no un hecho establecido. Fuentes: política de escalado responsable de Anthropic; Dario Amodei, 12 de septiembre de 2026.
- Los ensayos de la semana. El 6 de septiembre, Jakub Pachocki escribió en OpenAI que ningún laboratorio ha resuelto la alineación y la supervisión lo bastante como para seguir escalando a máxima velocidad, y que espera ralentizaciones voluntarias hasta que existan listones de seguridad compartidos, exigibles por auditores, agencias o instancias internacionales. El 12, Dario Amodei publicó We Must Pace the Frontier: acompasar no es detener el entrenamiento; Anthropic se compromete de forma unilateral a evaluadores externos con acceso comparable al de un empleado; la coordinación entre laboratorios de democracias exigiría, por razones antimonopolio, un cauce o una exención del gobierno; el ritmo no puede rebasar la ventaja sobre China, y un pacto global sin verificación férrea sería, a su juicio, militarmente existencial si la otra parte hace trampas. Ninguno de los dos textos es un acuerdo de industria ni una pausa en vigor. Fuentes: OpenAI, 6 de septiembre de 2026; Dario Amodei, 12 de septiembre de 2026.
- Anthropic y la acción unilateral. En febrero de 2026, Anthropic reconoció que algunos umbrales de capacidad habían resultado más ambiguos de lo esperado, que la política pública avanzaba despacio y que ciertas mitigaciones futuras podrían ser imposibles de implementar sin acción colectiva. Su nueva política separa las medidas que promete adoptar por sí misma de las que considera necesarias para toda la industria. Fuente: Anthropic, Responsible Scaling Policy 3.0.
- OpenAI y el freno común. Wired informó el 10 de septiembre de que OpenAI había pedido a miembros del Congreso claridad sobre si coordinar una ralentización del desarrollo de modelos de frontera podría infringir las leyes antimonopolio. La información procede de personas cercanas a la empresa; OpenAI no respondió antes de la publicación. El medio también señala que la legalidad dependería de los detalles concretos del acuerdo y que existe una propuesta legislativa para permitir cierta coordinación en seguridad. Fuente: Wired.
- La carrera y la conducta. Un experimento publicado como prepublicación en julio de 2026 encontró que los participantes rezagados en una carrera de IA idealizada tendían más a elegir desarrollo inseguro y que la conducta del rival influía en decisiones posteriores. Los autores advierten que la evidencia empírica directa sigue siendo limitada. Es un juego experimental, no una observación de las decisiones internas de OpenAI o Anthropic. Fuente: Fernández Domingos y Han, arXiv 2607.26034.